
94 БАЛЛОВ
NEW
- Код товара
- ПроизводительNVIDIA
- Цена в бонусных баллах9400
- Доставка, дн.12 - 15
- СостояниеНОВОЕ
94 000 ₽
- Графический процессорGV100
- Видеопроцессор, MHz1380
- Частота памяти, MHz877
- Объём видеопамяти (GB)32
- Все характеристики
Проверка и тестирование перед отправкой
Полный возврат средств, если товар не соответствует требованиям
Гарантия получения товара в соответствии с бланком заказа
Безопасность платежей гарантируется SSL-протоколом
Гарантия качества продукта
Страховка на весь период доставки заказа
В комплекте дешевле
94 000 ₽
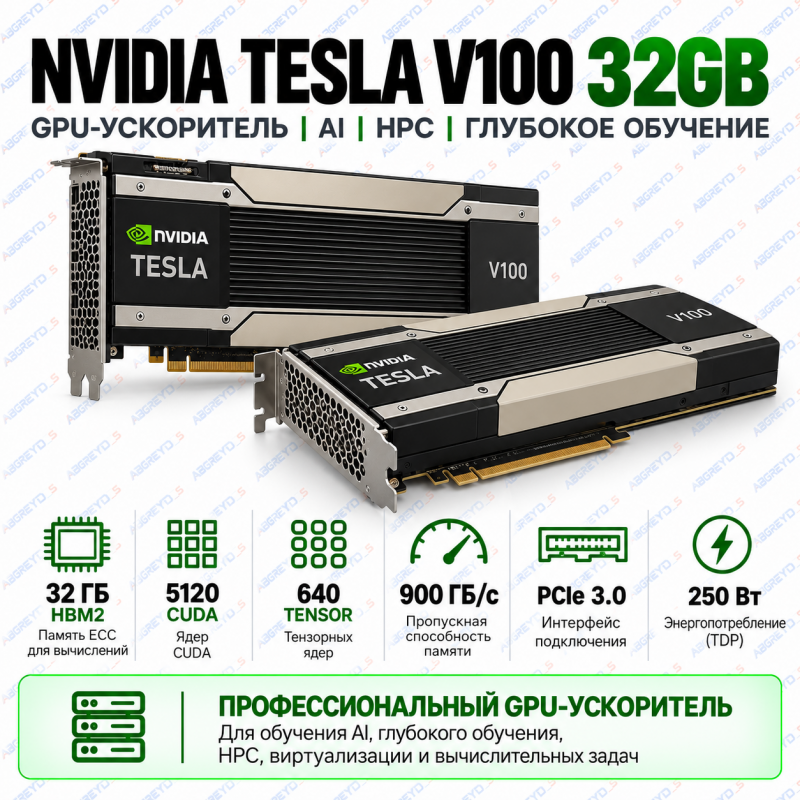
Серверный GPU-ускоритель с 32 ГБ HBM2 ECC для AI и HPC
NVIDIA Tesla V100 32GB HBM2 PCIe
Профессиональный GPU-ускоритель для машинного обучения, нейросетей, научных вычислений и виртуализации. Архитектура Volta, 5120 CUDA-ядер, 640 Tensor-ядер и 32 ГБ высокоскоростной памяти HBM2 ECC.
32 ГБ
Память HBM2 ECC
5120
CUDA-ядер
900 ГБ/с
Пропускная способность
112 TFLOPS
Тензорные вычисления
Архитектура NVIDIA Volta 5120 CUDA-ядер для параллельных вычислений, научных задач и GPU-ускорения.
640 Tensor-ядер Аппаратное ускорение матричных операций для искусственного интеллекта и глубокого обучения.
32 ГБ памяти HBM2 ECC Высокоскоростная память с 4096-битной шиной и пропускной способностью до 900 ГБ/с.
Серверное исполнение Интерфейс PCIe 3.0 x16, пассивное охлаждение и энергопотребление до 250 Вт.
Ключевые преимущества NVIDIA Tesla V100 32GB:
- Профессиональный вычислительный GPU для серверов.
- Графическая архитектура NVIDIA Volta.
- 5120 вычислительных ядер NVIDIA CUDA.
- 640 специализированных Tensor-ядер.
- 80 потоковых мультипроцессоров.
- 32 ГБ высокоскоростной памяти HBM2.
- Поддержка коррекции ошибок памяти ECC.
- 4096-битная шина видеопамяти.
- Пропускная способность памяти до 900 ГБ/с.
- Производительность FP32 до 14 TFLOPS.
- Производительность FP64 до 7 TFLOPS.
- Тензорная производительность до 112 TFLOPS.
- Максимальная частота GPU 1380 МГц.
- Интерфейс PCI Express 3.0 x16.
- Поддержка NVIDIA CUDA и совместимых библиотек.
- Аппаратное ускорение обучения нейронных сетей.
- Возможность применения в совместимых средах виртуализации.
- Пассивная система охлаждения для серверного обдува.
- Энергопотребление до 250 Вт.
Технические характеристики:
| Параметр | Значение |
| Производитель | NVIDIA |
| Модель | Tesla V100 PCIe 32GB |
| Серия | NVIDIA Tesla V-Series |
| Тип устройства | Серверный GPU-ускоритель |
| Назначение | AI, Deep Learning, HPC, GPU Computing |
| Архитектура | NVIDIA Volta |
| Графический процессор | GV100 |
| Техпроцесс | 12 нм FinFET |
| Количество транзисторов | 21,1 млрд |
| CUDA-ядра | 5120 |
| Tensor-ядра | 640 |
| Потоковые мультипроцессоры | 80 SM |
| Базовая частота GPU | 1245 МГц |
| Максимальная частота GPU | 1380 МГц |
| Производительность FP32 | До 14 TFLOPS |
| Производительность FP64 | До 7 TFLOPS |
| Тензорная производительность | До 112 TFLOPS |
| Объём памяти | 32 ГБ |
| Тип памяти | HBM2 |
| Поддержка ECC | Есть |
| Максимальная частота памяти | 877 МГц |
| Шина памяти | 4096 бит |
| Пропускная способность памяти | До 900 ГБ/с |
| Интерфейс подключения | PCI Express 3.0 x16 |
| CUDA Compute Capability | 7.0 |
| Вычислительные интерфейсы | CUDA, OpenCL, OpenACC |
| Виртуализация GPU | В поддерживаемых конфигурациях NVIDIA vGPU |
| Видеовыходы | Отсутствуют |
| Система охлаждения | Пассивная, серверный радиатор |
| Необходимый обдув | Принудительный воздушный поток |
| Энергопотребление | 250 Вт |
| Дополнительное питание | 8-pin CPU EPS12V |
| Форм-фактор | PCIe Full Height / Full Length |
| Толщина | 2 слота расширения |
| Длина | 266,7 мм |
| Высота | 111,2 мм |
| Платформа | Серверы и вычислительные рабочие станции |
| Операционные системы | Linux, Windows при наличии совместимых драйверов |
Архитектура NVIDIA Volta:
- 5120 CUDA-ядер: параллельная обработка вычислительных задач.
- 80 мультипроцессоров: распределение нагрузки между вычислительными блоками GPU.
- 640 Tensor-ядер: ускорение матричных операций при глубоком обучении.
- FP32 до 14 TFLOPS: вычисления одинарной точности.
- FP64 до 7 TFLOPS: научные и инженерные расчёты двойной точности.
- Tensor Performance до 112 TFLOPS: ускорение поддерживаемых операций смешанной точности.
Высокоскоростная память 32 ГБ HBM2:
- Объём 32 ГБ: размещение больших массивов данных, нейронных сетей и промежуточных результатов вычислений.
- Технология HBM2: высокоскоростная память с широкой шиной передачи данных.
- 4096-битная шина: высокая производительность обмена данными между памятью и GPU.
- 900 ГБ/с: пропускная способность для интенсивных вычислительных нагрузок.
- ECC: поддержка обнаружения и исправления определённых ошибок памяти.
- Большие модели: увеличенный объём видеопамяти позволяет работать с более крупными моделями и пакетами данных по сравнению с версией 16 ГБ.
Искусственный интеллект и глубокое обучение:
- Deep Learning: ускорение обучения и использования нейронных сетей.
- Machine Learning: выполнение совместимых алгоритмов машинного обучения.
- Tensor Cores: аппаратное ускорение операций с матрицами.
- PyTorch: работа с совместимыми версиями CUDA и фреймворка.
- TensorFlow: ускорение вычислений при наличии поддерживаемого программного окружения.
- GPU-инференс: выполнение обученных моделей, помещающихся в доступную память.
- 32 ГБ HBM2: дополнительный объём памяти для моделей, промежуточных тензоров и вычислительных задач.
Научные и высокопроизводительные вычисления:
- HPC: высокопроизводительные параллельные вычисления.
- FP64: высокая производительность операций двойной точности.
- Математическое моделирование: решение больших вычислительных задач.
- Научные исследования: физика, химия, биоинформатика и численные расчёты.
- Обработка данных: GPU-ускорение алгоритмов анализа числовых массивов.
- Вычислительные кластеры: применение в совместимых серверных конфигурациях.
Виртуализация и серверное применение:
- Серверное исполнение: конструкция предназначена для вычислительных систем.
- NVIDIA vGPU: виртуализация в совместимой инфраструктуре при наличии требуемых лицензий.
- Многопользовательские среды: использование ускорителя в поддерживаемых виртуализированных конфигурациях.
- GPU Computing: выполнение параллельных вычислительных задач.
- CUDA: поддержка профессиональных приложений и вычислительных библиотек.
- Мониторинг: использование NVIDIA Management Library и совместимых инструментов.
Охлаждение и питание:
- Пассивная система охлаждения: ускоритель не оснащён собственным вентилятором.
- Серверный обдув: необходим направленный поток воздуха через радиатор.
- Энергопотребление: до 250 Вт.
- Дополнительное питание: разъём 8-pin EPS12V; необходимо проверить соответствие кабеля и распиновки.
- PCIe 3.0 x16: установка в совместимые серверные платы.
- Двухслотовое исполнение: требуется соответствующее пространство в корпусе.
- Без видеовыходов: для подключения монитора необходимо другое графическое устройство.
Оптимально подходит для:
- Серверов искусственного интеллекта.
- Машинного и глубокого обучения.
- Обучения нейронных сетей.
- GPU-инференса совместимых моделей.
- Научных вычислений HPC.
- Инженерных и математических расчётов.
- Систем NVIDIA CUDA.
- Серверов GPU Computing.
- Вычислительных рабочих станций.
- Совместимых сред NVIDIA vGPU.
- Обработки больших массивов данных.
- Исследовательских вычислительных систем.
Особенность модели 32 ГБ: NVIDIA Tesla V100 32GB оснащена вдвое большим объёмом видеопамяти по сравнению с версией 16 ГБ. Это позволяет размещать более крупные нейронные сети, вычислительные массивы и промежуточные данные непосредственно в памяти ускорителя. При этом сохраняются 5120 CUDA-ядер, 640 Tensor-ядер и пропускная способность до 900 ГБ/с.
Важная информация об охлаждении: NVIDIA Tesla V100 PCIe 32GB оснащена пассивной системой охлаждения и требует принудительного серверного обдува. Установка в обычный настольный корпус без подходящего охлаждения не рекомендуется.
Совместимость: Для установки необходим совместимый слот PCIe x16, правильное подключение дополнительного питания и достаточный воздушный поток. Видеовыходы отсутствуют. Перед использованием современных AI-фреймворков необходимо проверить поддержку архитектуры Volta, CUDA Compute Capability 7.0 и требуемых драйверов.
Итоговый вывод: NVIDIA Tesla V100 PCIe 32GB HBM2 — профессиональный серверный GPU-ускоритель для искусственного интеллекта, глубокого обучения, научных расчётов и HPC. Модель сочетает 32 ГБ памяти ECC, 5120 CUDA-ядер, 640 Tensor-ядер и пропускную способность памяти до 900 ГБ/с. Ускоритель подходит для вычислительных серверов и профессиональных систем с совместимым программным обеспечением и серверным охлаждением.
Video card
- Графический процессорGV100
- Видеопроцессор, MHz1380
- Частота памяти, MHz877
- Объём видеопамяти (GB)32
- Разрядность шины видеопамяти, Bit4096
- Тип видеопамятиHBM2
Габариты и вес
- Вес2 кг
Зарегистрируйся, оставляй отзывы о товаре, зарабатывай бонусы!
Отзывов: 0
Нет отзывов о данном товаре.
Вопросов: 0
Пока нет вопросов об этом товаре. Станьте первым!
Отсканируйте QR-код камерой вашего устройства и мгновенно добавьте нас в контакты мессенджера. Получите бесплатную консультацию — удобно и просто!


Tesla V100
V100 32GB
HBM2
ECC
GPU Accelerator
Volta
CUDA
Tensor Cores
AI
HPC
Deep Learning
Machine Learning
PCIe 3.0
серверный GPU
Похожие товары


